
Begärda sidor och liveström
Sök URL:er, filtrera per leverantör och se de senaste begärandena med crawleridentitet och syfte.
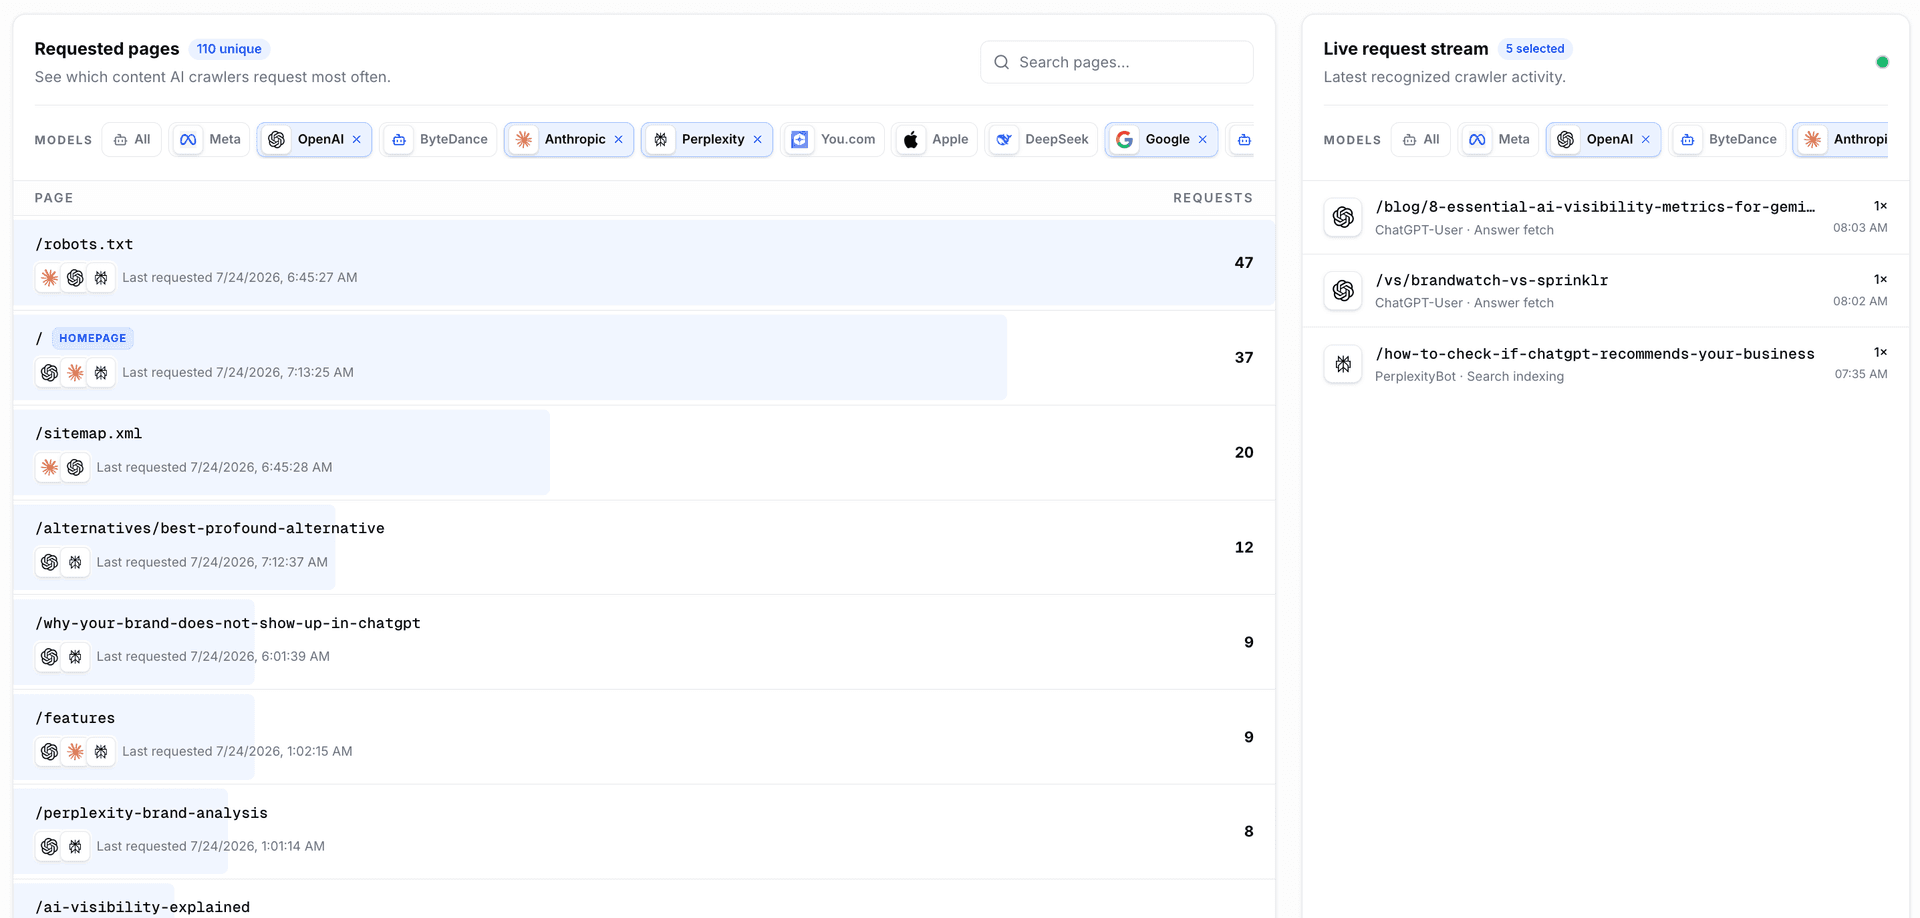
Se vilka identifierade AI-crawlare och agenter som begär webbplatsen, vilka URL:er de når och vilket syfte varje begäran klassificeras som.
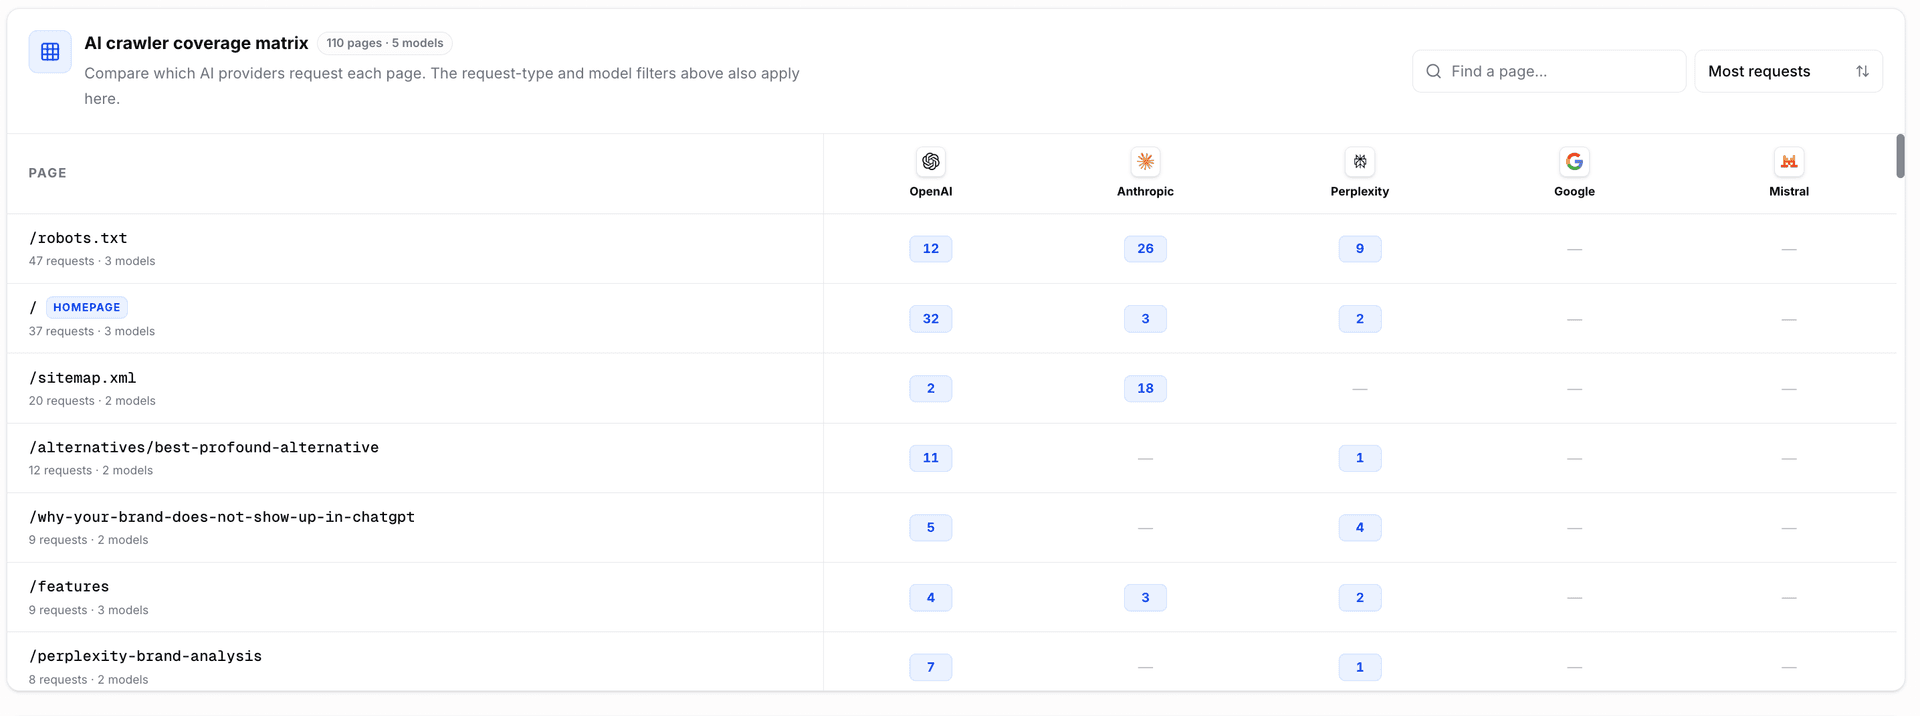
Gemensamma filter håller graf, sidor, liveström och täckningsmatris jämförbara.

Sök URL:er, filtrera per leverantör och se de senaste begärandena med crawleridentitet och syfte.
Matrisen visar vilka leverantörer som nått prioriterade sidor och var en teknisk kontroll behövs.
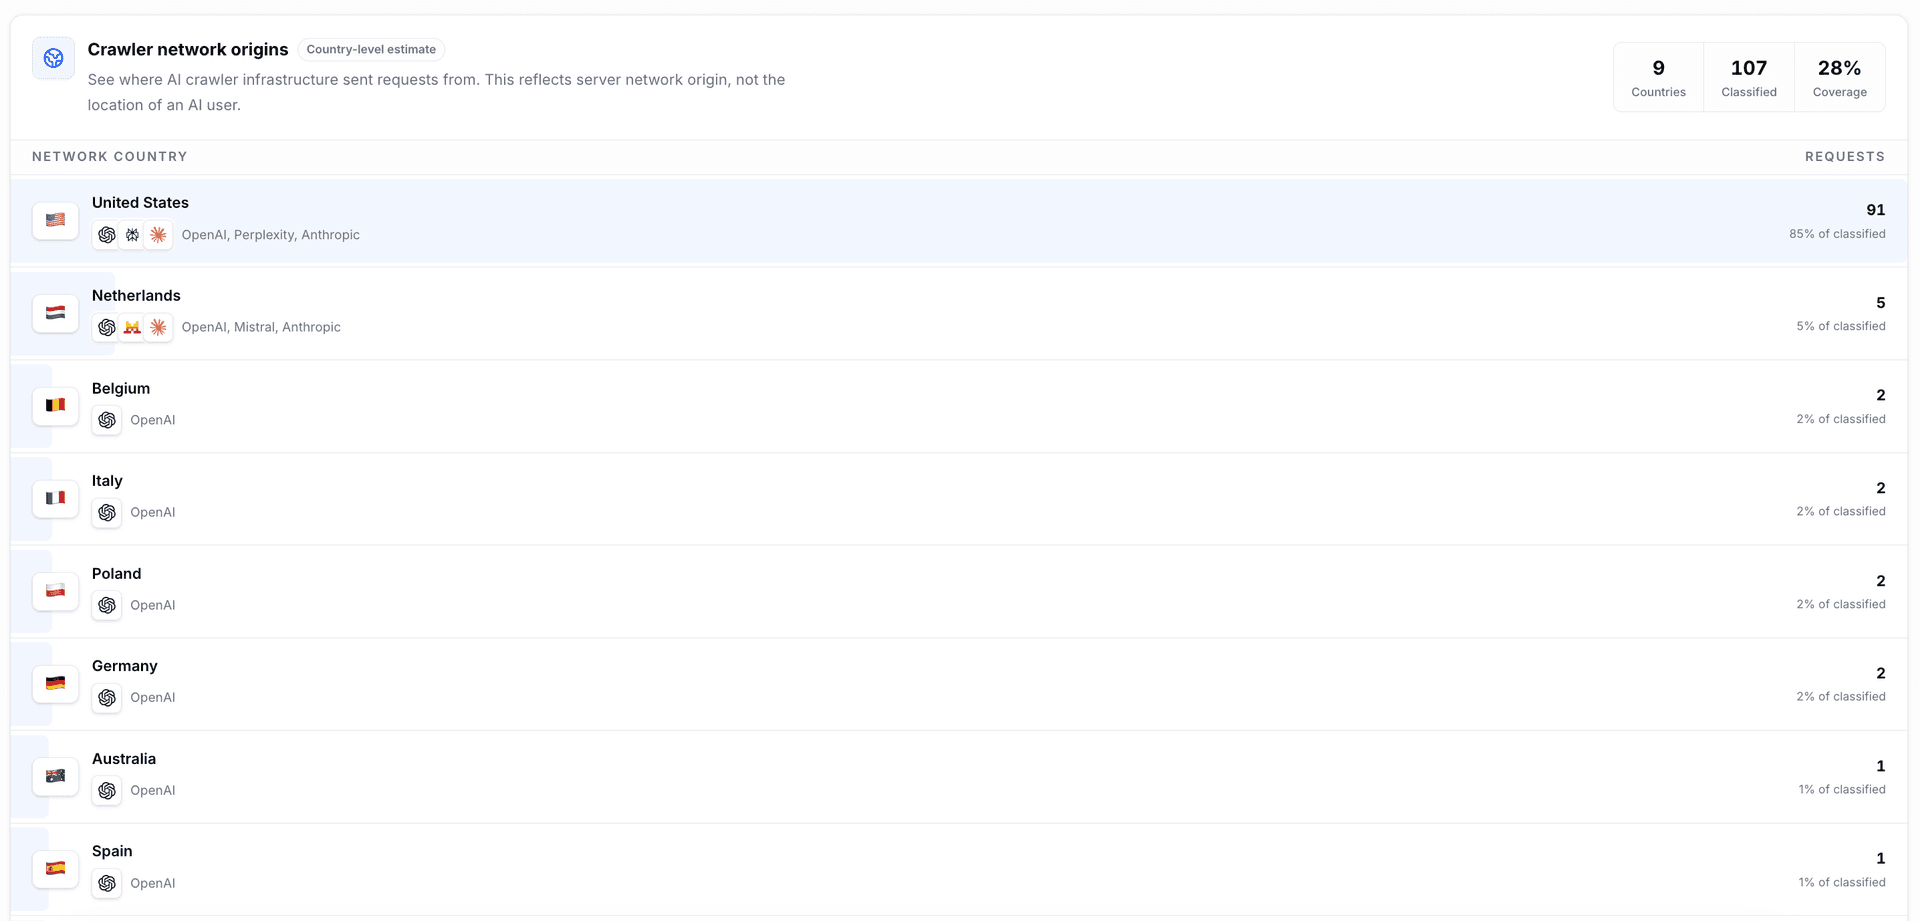
Länder grupperar begäranden efter uppskattat nätverksursprung när tillförlitlig hostingdata finns.
Vyn visar inte var personen som använder ChatGPT, Claude eller en annan AI-tjänst befinner sig.
Brand Armor AI registrerar kvalificerade GET- och HEAD-begäranden på serversidan. Därmed syns AI-crawlare som inte kör vanliga webbanalysskript.
Begäranden delas upp i AI-svar, sökning och indexering, träning och andra AI-agenter. En begäran bevisar åtkomst, inte automatiskt indexering, träning, citering eller rekommendation.
Filtrera efter leverantör och syfte för att förstå toppar i begäranden.
Sök efter prioriterade URL:er och se vilka AI-ekosystem som nått dem.
Kontrollera robots-regler, rendering, statuskoder och tillgänglighet.
Jämför crawleråtkomst med promptresultat och citationer utan att blanda ihop signalerna.
Övervakningen visar begärd sida, identifierad crawler, tidpunkt, statuskod och tillgänglig syftesklassificering.
Tillsammans med promptövervakning och citationsdata går det att skilja teknisk åtkomst från faktisk synlighet i AI-svar.
Paketet @brandarmorai/ai-search-crawler stöder Next.js, Express, Cloudflare Workers och Pages, Hono, Bun och Deno.
Frågeparametrar tas bort som standard. Cookies, request bodies och auktoriseringsheaders skickas inte.
Spårningen är utformad för att inte blockera webbplatsens svar om analystjänsten inte är tillgänglig.
Nej. Den bevisar åtkomst från en identifierad crawler eller agent. Indexering, träning, citering och rekommendation är separata signaler.
Nej. Vanliga crawler- och agentbegäranden innehåller inte den ursprungliga prompten.
Nej. Webbläsaranalys mäter främst mänskliga sessioner. Brand Armor AI registrerar kvalificerade AI-begäranden på servern.
Next.js, Express, Cloudflare Workers och Pages, Hono samt Fetch-kompatibla runtimes som Bun och Deno.
De här relaterade lösningarna hjälper team att sätta Begäranden per leverantör, crawler och syfte i ett bredare arbetsprogram och prioritera nästa steg tydligare.